産業分野におけるUnityの活用をテーマに開催されたオフライントークセッションイベント、「Unity Industry Meetup Tokyo」が6月26日(金)、ボーンデジタル セミナールームにて開催された。
製造、建築、XR、デジタルツインといった分野でリアルタイム3D技術の活用が広がる中、実際にUnityを用いて産業向けプロジェクトに取り組む4社が登壇し、開発事例やワークフロー、現場で得られた知見を紹介した。本記事では、イベント内で行われた各セッションの模様をダイジェストでお届けする。
OPENING:ユニティ・テクノロジーズ・ジャパンによる開会挨拶
開会にあたりユニティ・テクノロジーズ・ジャパンの中村氏が登壇。産業分野でのUnity活用は事例こそ多いものの、業界を超えた横のつながりが少ないという課題意識から、本イベントの開催に至ったことが語られた。中村氏は普段Unity Industry領域の営業を担当しており、「面白い技術を持っている」「知見を共有してほしい」と感じた企業に声をかけ、今回の登壇に至ったという経緯も明かした。
「産業分野でUnityを使っている人は孤独じゃない」というメッセージのもと、和やかな雰囲気のなか、実際に現場でUnityを最大活用している4社の担当者へとバトンが渡された。
SESSION01:Niantic Spatialの3D ReconstructionとVPSの紹介|Niantic Spatial
最初のセッションに登壇したのは、Niantic Spatialの白石氏と松下氏。同社の前身は位置情報技術を手がけるKeyholeで、Googleによる買収ののちGoogle Earth/Google Mapへとつながった歴史を持つ。現在はエンタープライズ事業へと大きく舵を切り、25年にわたり磨いてきた位置情報・空間理解技術を産業分野へ展開しているという。
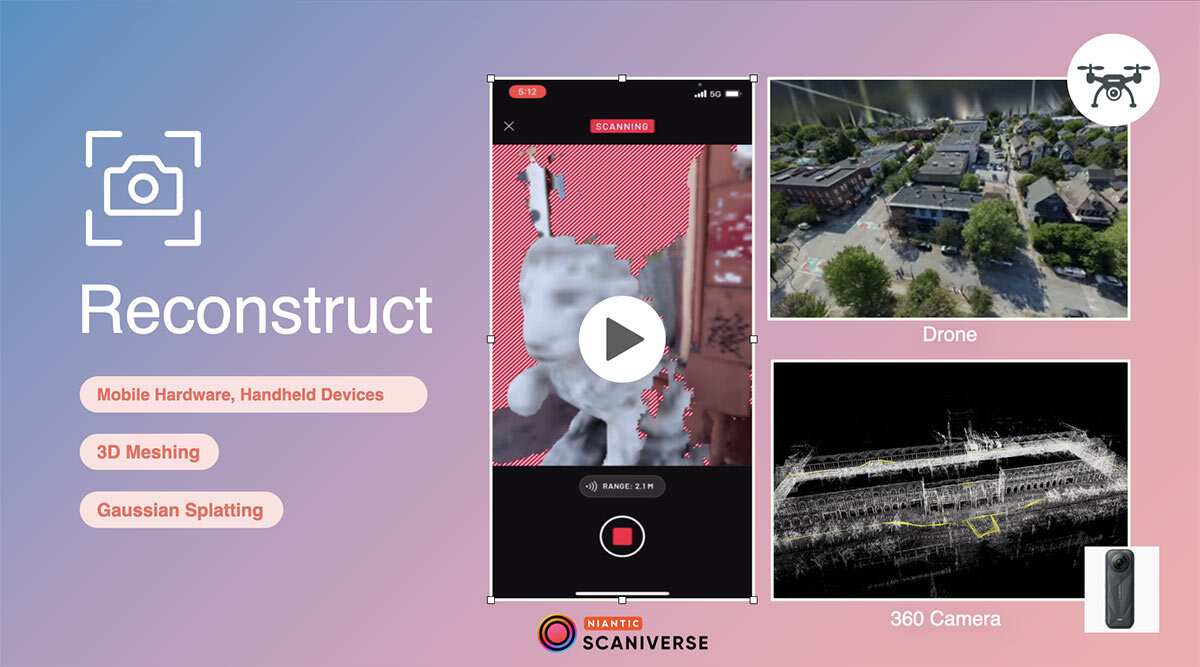
前半、白石氏が紹介したのは同社のコア技術。360°カメラやドローン、スマートフォンなど、比較的安価な機材から高精度な3D空間データを生成する「3D Reconstruction(サービス名:Scaniverse)」は、この1年でアルゴリズムをクラウド側へ移植し、より大規模な空間の3D化に対応した。生成したデータはOpenUSD形式でも出力可能で、SIM to Realと呼ばれるロボティクス・シミュレーション分野からの引き合いも増えているという。
そしてもう一つの柱が、生成した3DデータをもとにGPSを補う高精度な位置合わせ「VPS(Visual Positioning System)」だ。
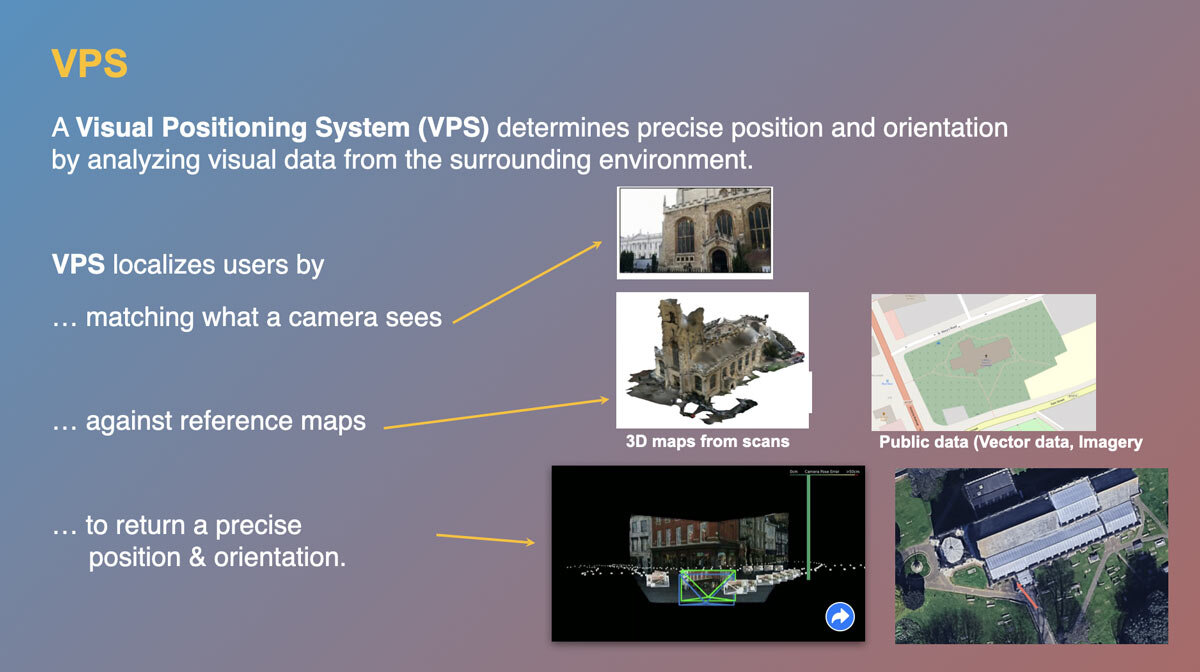
カメラ画像とあらかじめ取得した3Dデータを照合し、6DoF(位置と向き)でユーザーの位置を返す仕組みで、玄関先に置いた荷物の受け渡し場所をAR上で指定・共有するデモや、ロサンゼルスで実施したロボットの走行実験(GPSは高層ビル街で大きく測位がブレる一方、VPSは安定した軌跡を描いた比較映像)が紹介された。
また、航空写真とスマートフォン画像をマッチングさせる研究開発中の技術や、フードデリバリーロボット企業Cocoro Roboticsとのパートナーシップにも言及し、「3Dは見るだけでなく、位置合わせに使えるデータへ」というメッセージが強調された。
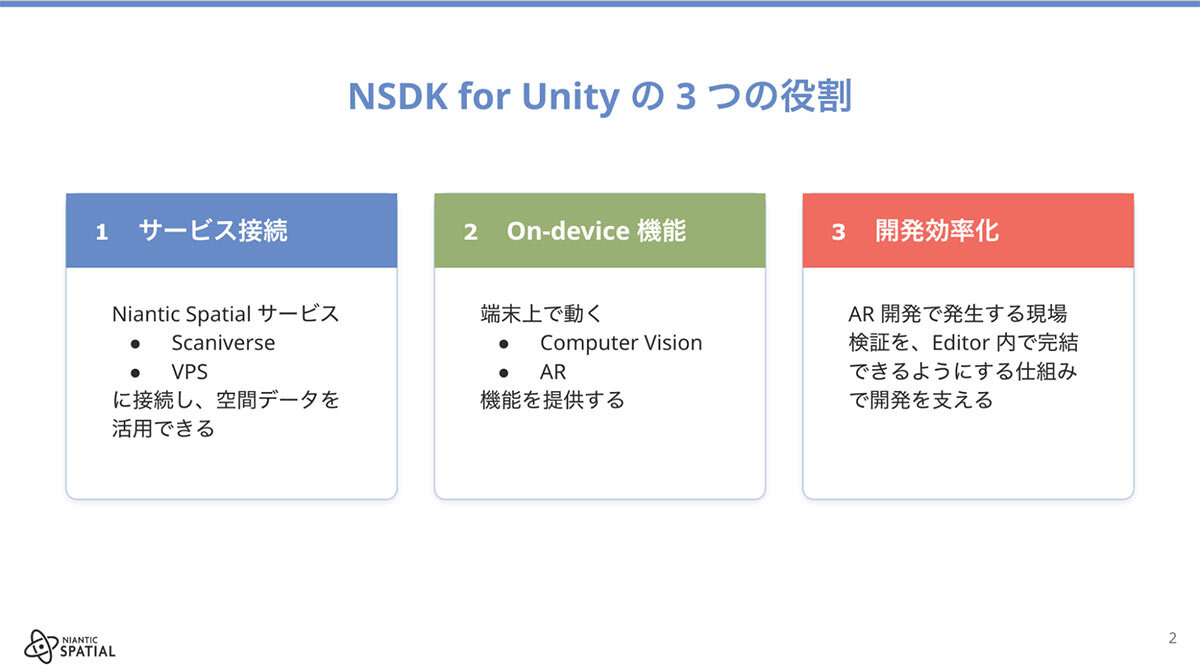
後半は、松下氏がUnity開発者視点で両技術を統合するSDK「NSDK」を解説。iOS・Android・Quest 3といったマルチデバイスに単一コードで対応できる点に加え、Scaniverseのクラウド空間データへの接続、リアルタイムに動作するデプス・セマンティクス・メッシングといったオンデバイス機能、そして開発効率化の3つの役割を持つと整理した。
なかでも注目を集めたのが「プレイバックレコーディング」機能だ。現地でのARライブセッションをカメラ映像・深度・GPS・姿勢情報・タイムスタンプごと記録するもので、記録済みのデータさえあれば、以降はUnityエディタ上で何度でも再生しながら開発・デバッグを繰り返せる。
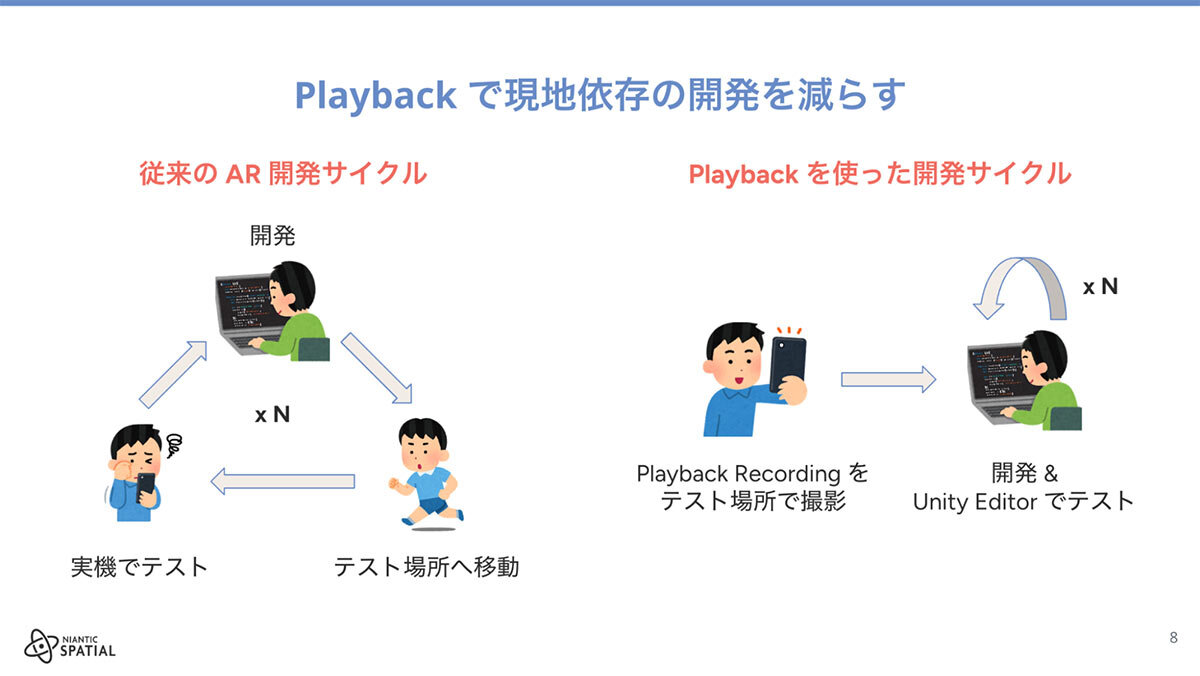
従来のAR開発は「エディタで実装→ビルド→現地でテスト→修正」というサイクルを現地依存で繰り返す必要があったが、プレイバックを使えば現地作業を最初の1回に集約し、その後の試行錯誤を手元で完結できる。ライブセッションとプレイバックでアプリ側の実装コードが変わらない設計(AR Foundationのサブシステム層を介して入力ソースだけが切り替わる構成)も紹介され、チーム開発における役割分担にも効くと結んだ。最後に、GitHub上で公開されているUnity向けサンプル「NSDK Samples C#」が紹介され、同氏はNSDKの対応プラットフォーム拡張に伴いROS2開発のキャッチアップも進めているという。
SESSION02:AIを活用したUXML実装の自動化と最適化|ホロラボ
第2セッションはホロラボの田野氏が登壇。同氏はゲーム会社でのディレクター経験やデジタルマーケティング会社でのAR/VR研究開発を経てホロラボに入社し、Project PLATEAUの一環となる市民参加型まちづくりARアプリや、博物館・観光地向けAR/VR/MRコンテンツなどを手がけている。今回は、地方自治体でも活用されているXRプラットフォーム「torinome(トライノーム)」のUI統合を題材に、AIとUnityのUI Toolkit(UXML)を組み合わせたUI実装効率化の実務ノウハウが共有された。
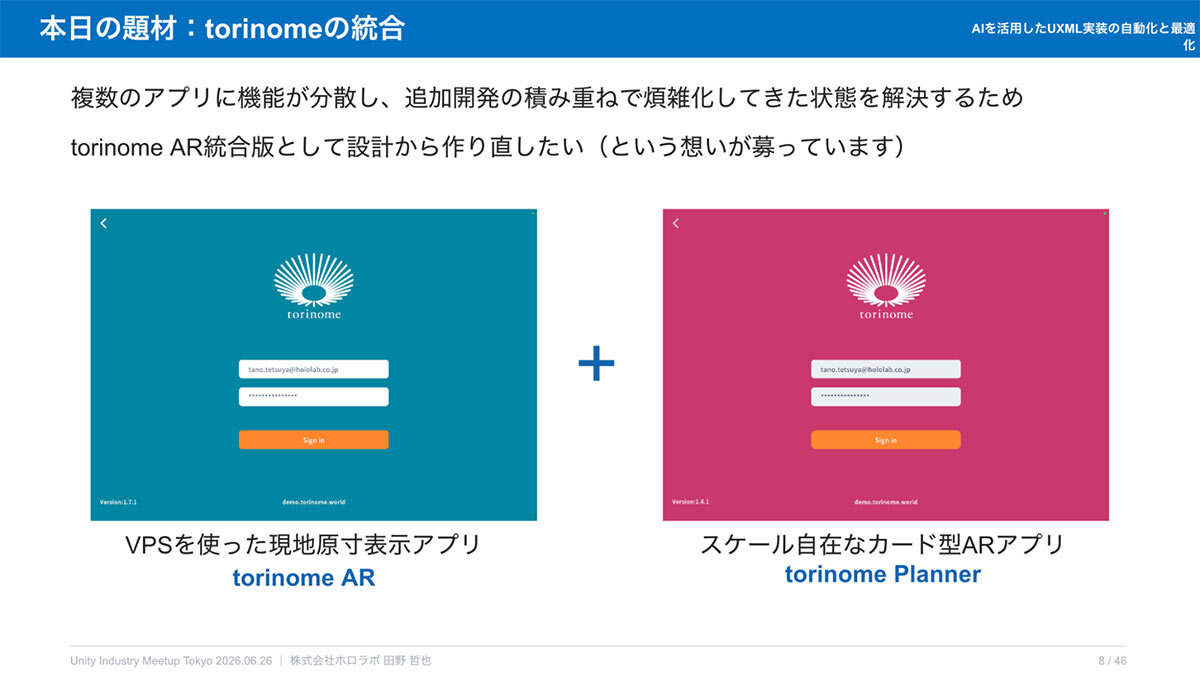
torinomeは、Web地図上に配置した3Dモデルやテキスト・画像データを、現地でiPadアプリのARとしてシームレスに閲覧できるツール。ただしUI画面数・操作項目が非常に多く、VPSを活用し現地で原寸のCGを見るARアプリ、マーカーとなるカードを認識しながらテーブル上で俯瞰でCGをみるPlannerアプリと複数のアプリに機能が分散していたため、これらを1つの「統合版」へまとめる開発が進行している。
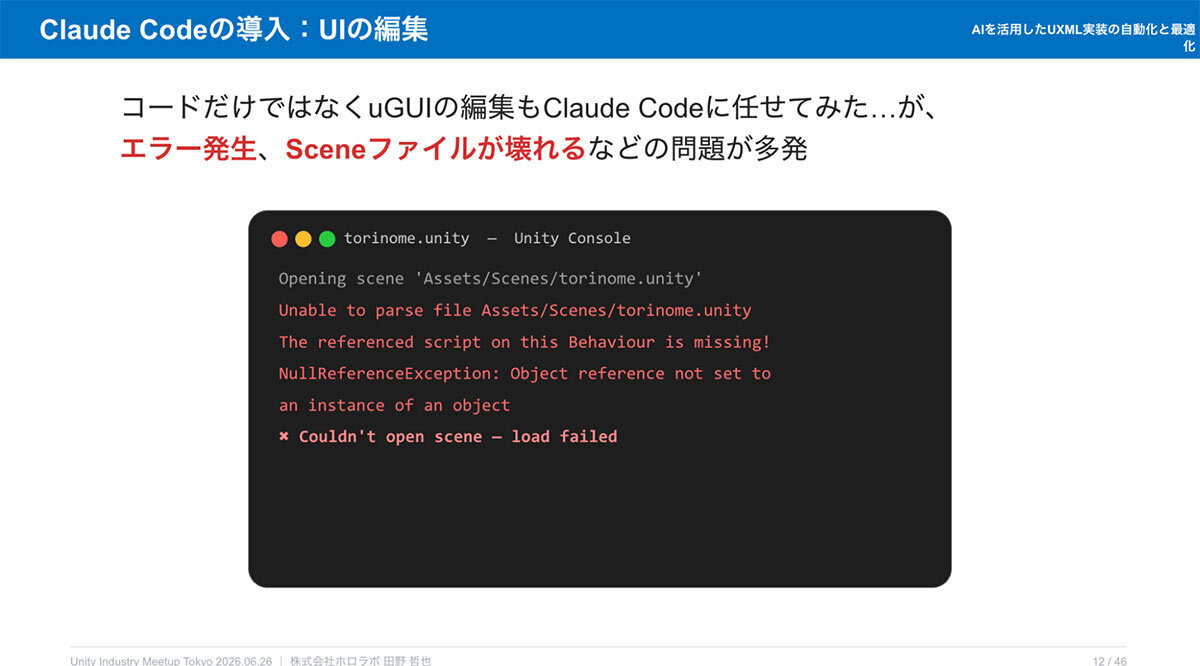
田野氏はまず、Claude CodeなどのAIエージェントを用いてロジック部分(データ表現や新機能実装)を効率化したところ、大きな手応えを得たと振り返る。しかし同じ勢いでUnity UI(uGUI/Canvas)の編集をAIに任せたところ、エラーが多発しシーンファイルが壊れる事態が頻発。その原因は、Canvasが1つのシーンファイル内にゲームオブジェクトの配置データとまとめて格納される構造にあり、巨大なファイルを読み書きする中でAIが混乱してしまうためだと分析した。「AIを導入したからUI実装が難しくなったわけではなく、相対的にUIの大変さが浮き彫りになった」という気づきが語られた。
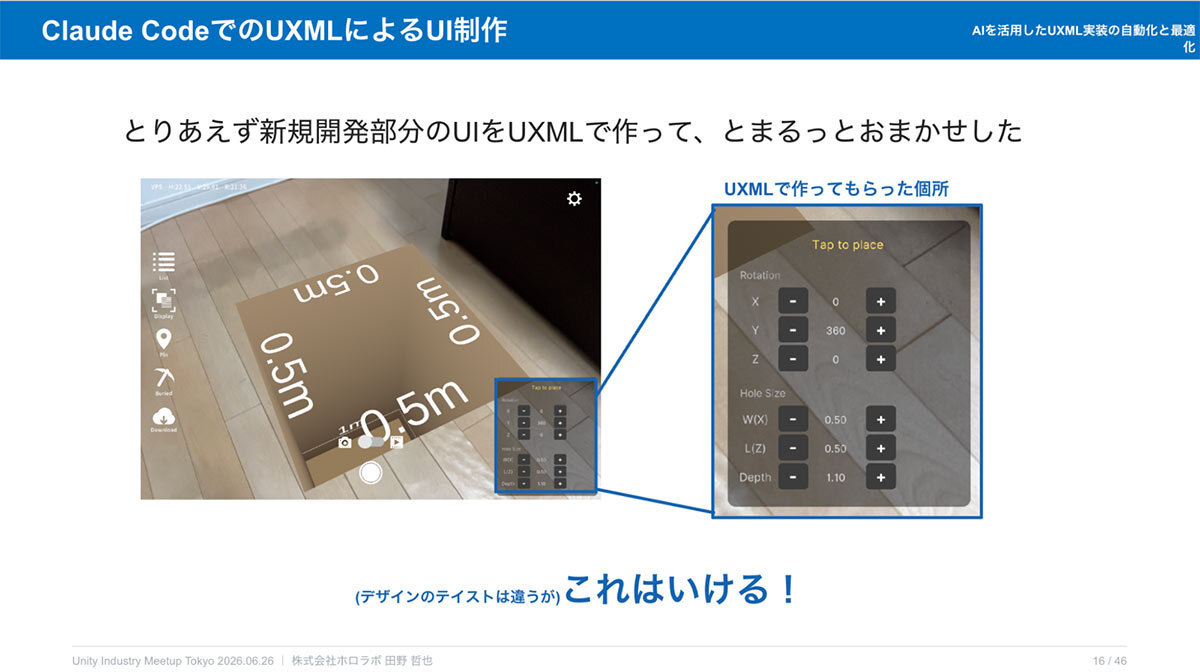
そこで着目したのが、テキストベースの外部ファイルとして構造・スタイル・ロジックを分離できるUnityのUI Toolkit(UXML/USS)だ。公式ドキュメントによればUXMLはHTML、USSはCSSに相当する設計思想を持つ「Webインスパイアード」な仕組みであり、実際に書き方を比較しても近しい構造を持つことが確認できた。そこで、デザイナーがFigmaなどで作成したデザインを一度HTMLへ変換し、Web制作経験のあるデザイナーがブラウザ上で調整、それをAIでUXMLへ変換するという新しいワークフローを構築した。
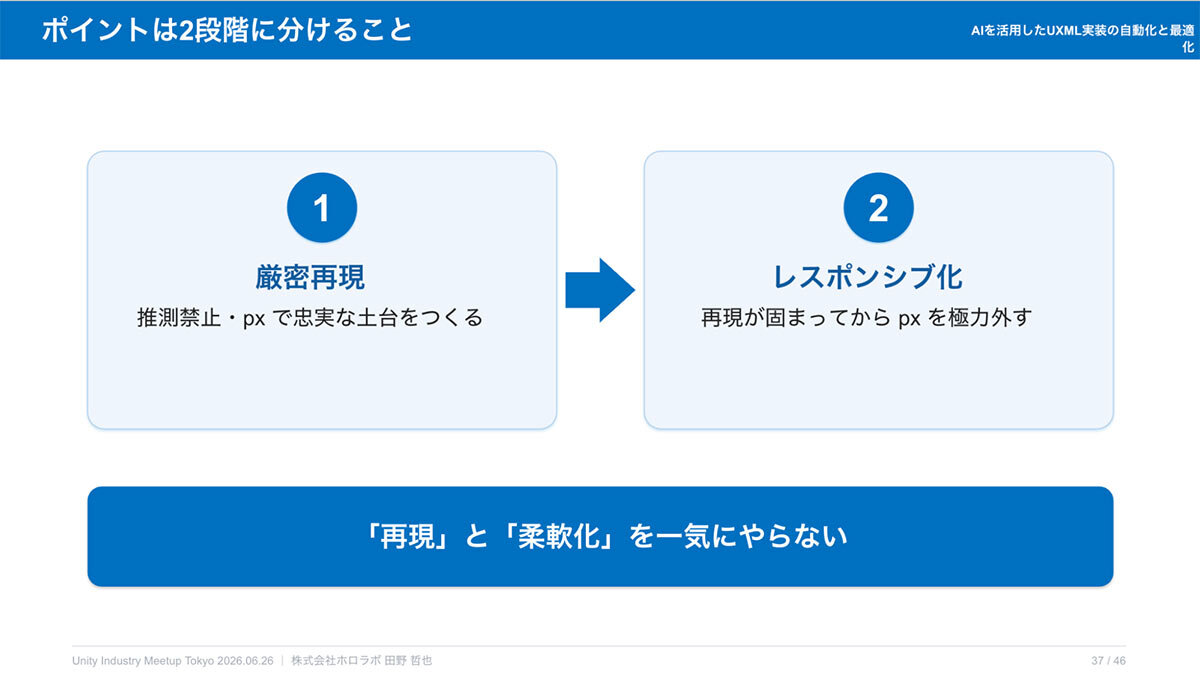
ポイントは「推測を絶対にしないでほしい」「ピクセル単位で厳密に再現してほしい」という具体的な指示を与えること。AIに任せると意図しない要素を勝手に補完してしまう、いわゆるハルシネーションが起きやすいため、既存プロジェクトを必ず参照させるルールを徹底したという。さらに「まず厳密にピクセル単位で再現し、その後にレスポンシブ対応する」という2段階のステップを踏むことで、画面サイズ差にも柔軟に対応できる完成度に到達できたと報告された。
実際に統合版アプリの開発工数を計測したところ、UI実装にかかる時間はログイン画面で20時間から6時間、VPS関連画面では23時間から3時間へと大幅に短縮。
ロジックとUIを合わせると、プロジェクト全体で約82%、最も効果の高かったVPS(Geospatial)関連画面では約90%の工数削減という結果が示された。一方で、Flexboxベースであることに起因する表現上の制約、動的なロジックを伴うUI(スクロール処理など)の移植には向かない点、既存のuGUI向けアセットがまだUXMLに揃っていない点、プロジェクトによっては再現性の検証がまだ1〜2件にとどまる点など、現時点での限界にも率直に言及。加えてUnity 6.2でUI ToolkitのワールドスペースUI配置が正式対応し、6.3では完全統合予定であることにも触れ、今後VR/AR領域でもUXMLの活用余地が広がるとの見立てを示した。「AIに任せすぎず、最終的には必ず人の目でチェックする」ことの重要性を強調し、講演を締めくくった。
SESSION03:Unityで構築するマルチデバイス空間共有プラットフォーム ~AWSバックエンド・生成AI・ガウシアンスプラッティングの実践~|スロースネットワークス
第3セッションはスロースネットワークスの渡邉氏が登壇。同氏は外資系半導体メーカーでのFAE経験、3Dモバイルミドルウェアメーカーでの自動車向けGUI開発ツール事業を経て、産業向けXR・空間コンピューティング領域へとキャリアを移してきた。同社が企画・開発するのが、車載機器や医療機器、産業機器などのUI/UXを、シチュエーションを再現した空間内で評価するツール「UI Labo Builder MR」である。
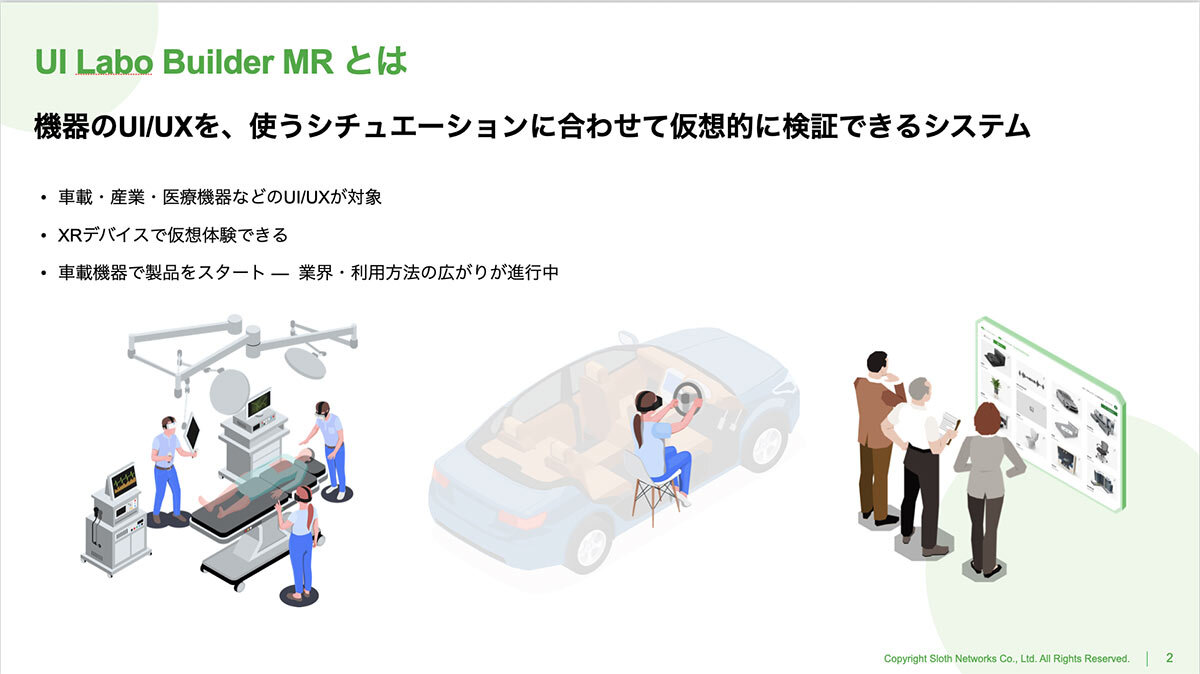
タッチパネル付きディスプレイのUIを評価する際、単に画面だけを見ても実際の使用感はつかみにくい。そこでXRデバイスを用いて車内や手術室などの環境を仮想的に再現し、その中にPC上で動作しているUIをリアルタイムに投影・タッチ操作できるようにしたのが同ツールの特徴だ。複数人が同時に、同じ空間、あるいは離れた場所からログインして一緒に検証できる。開発基盤としてUnityを選んだ理由には、3D空間表現力、XRデバイス向けSDKの提供の早さ、そしてiOS・Android・Windowsなど幅広いマルチプラットフォーム対応が挙げられた。
講演は大きく4つのテーマに沿って展開された。
バックエンド設計
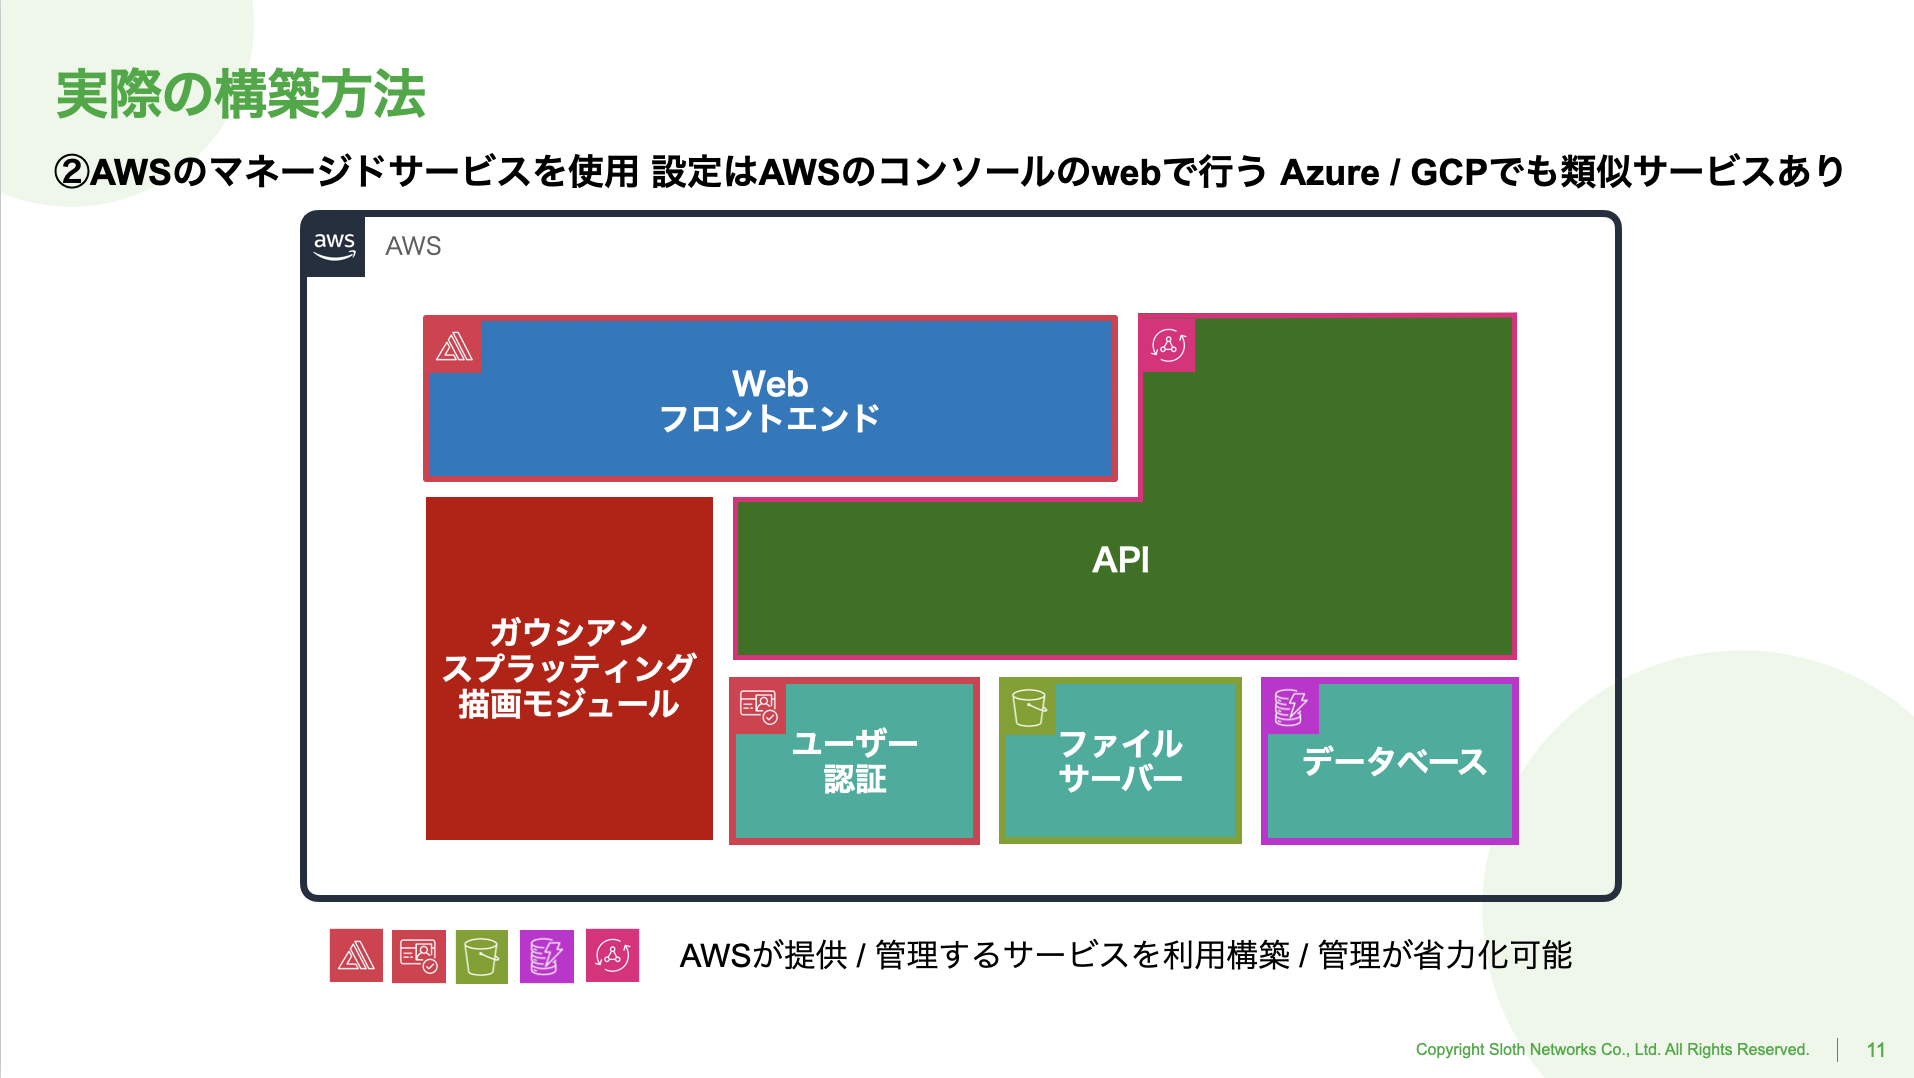
当初は仮想マシン上にフロントエンド・API・認証・ファイルサーバーなどを個別に構築していたが、AWSのフルマネージドサービス群をInfrastructure as Codeとして定義・構築できる『AWS Amplify Gen 2』を導入したことで、設定をソースコードとしてGit管理できるようになり、生成AIによる構成レビューや実装支援も可能になったという。UnityからAWS上のAPIを呼び出す際は、廃止されたMobile SDK for Unityに代わり「AWS SDK for .NET」を利用しているとのことだ。
音声認識と生成AIの統合
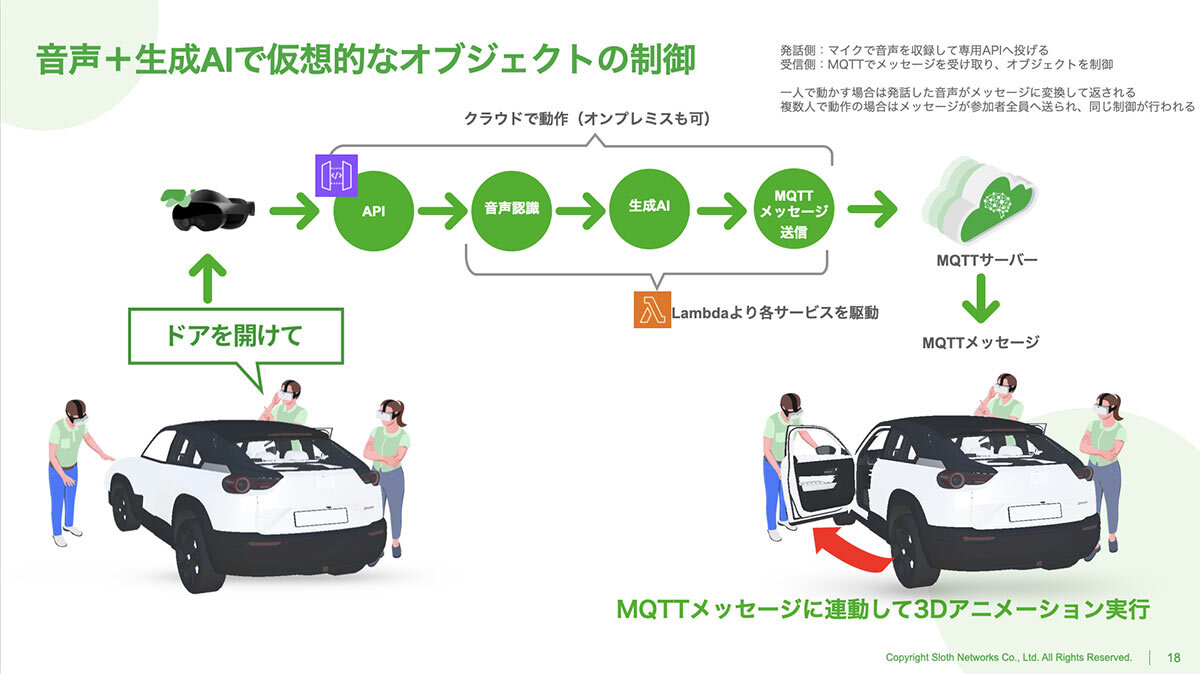
Meta Quest 3などで取得した音声をクラウドのAPIで受け取り、音声認識(Whisperまたは外部API)とChatGPT APIによる意味理解を経て、あらかじめ用意したコマンドリストと照合。複数ユーザーが同時に接続している状況でも、それぞれのクライアントに個別に指示を届けられるよう、IoT分野で用いられるMQTTプロトコルを採用している。実際に「ドアを開けて」と発話すると車のドアが開くアニメーションが再生されるデモも披露され、対応するアニメーションと音声コマンドの紐付けは簡単なCSV編集だけで拡張できるという。
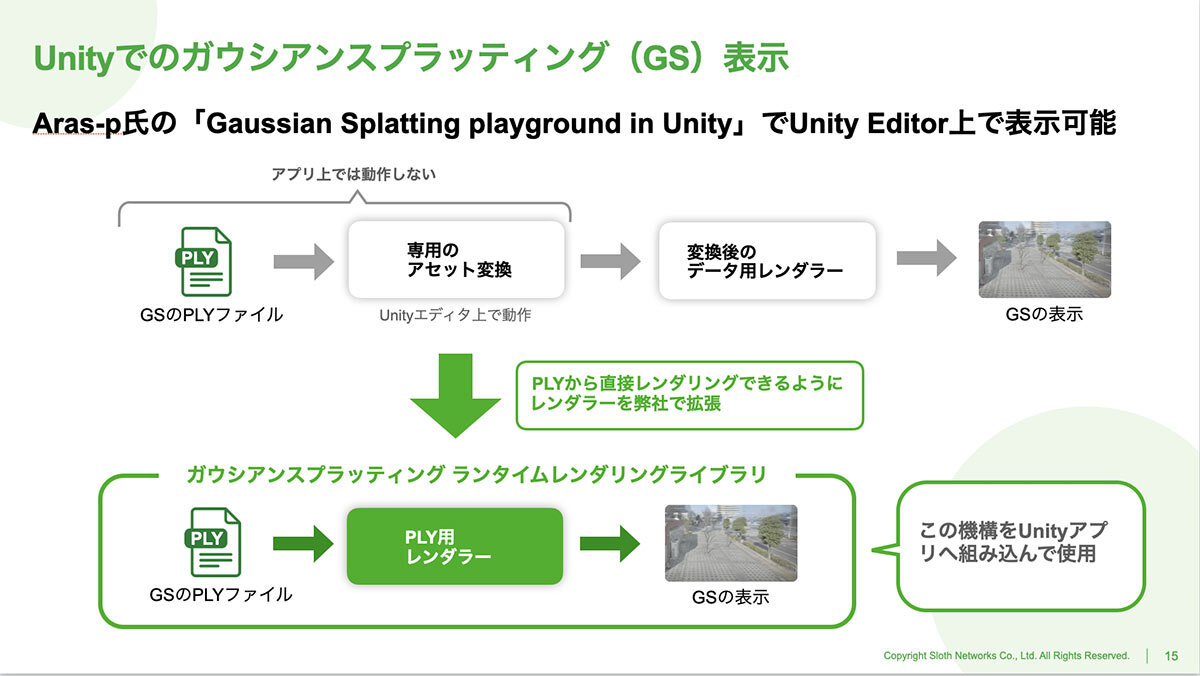
Unityでの3D Gaussian Splatting
既存のオープンソースを拡張して実現したガウシアンスプラッティングのランタイム描画にも言及。エディタ上での表示は既存のOSSでも比較的容易だが、ランタイムでの直接描画には手を加える必要があったといい、中間ファイルを生成することなくPLYファイルから直接読み込んで表示できるよう、OSSを独自に拡張した。
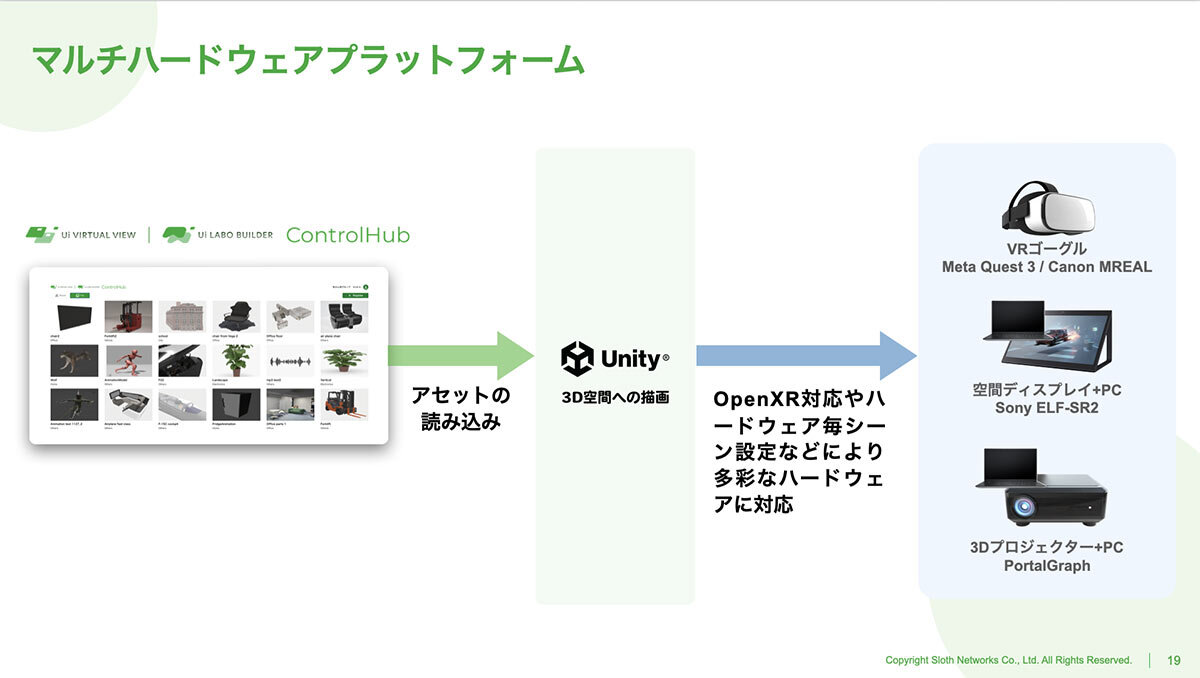
マルチハードウェアプラットフォーム
最後に、Meta Quest 3・ソニーの空間ディスプレイ(ELF-SR2)・HTC Viveトラッカーを使った3Dプロジェクター「Portalgraph」など、多様なデバイスへの対応について紹介。デバイスごとにSDKを使い分けつつ、プロジェクトを分離してビルドすることで競合やライブラリの不具合を避ける設計思想が語られた。会場では、Meta Quest 3とソニーの空間ディスプレイを同期させ、音声で車のドアを開閉するデモも披露され、同社がオンプレミス環境でも同等の機能を提供している点にも触れられた。
SESSION04:対話する身体をつくる:UnityによるAIアバター/Physical AIの動作生成|AVITA
最後のセッションは、AVITAの小栗氏が担当。大阪大学発の同社は、アンドロイド研究で知られる石黒浩教授が代表取締役を務めるスタートアップで、創業から6年目を迎える。「アバターで人類を進化させる」をミッションに掲げ、AIによる自律接客と遠隔操作を組み合わせたハイブリッド接客ツール「アバコム」、AIアバターによるロールプレイ研修サービス「アバトレ」を展開するほか、今年からはKDDIとのフィジカルAI領域における事業提携、Unitree・Booster RoboticsとのグローバルパートナーシップによるMOU締結など、人型ロボット領域への展開も加速している。
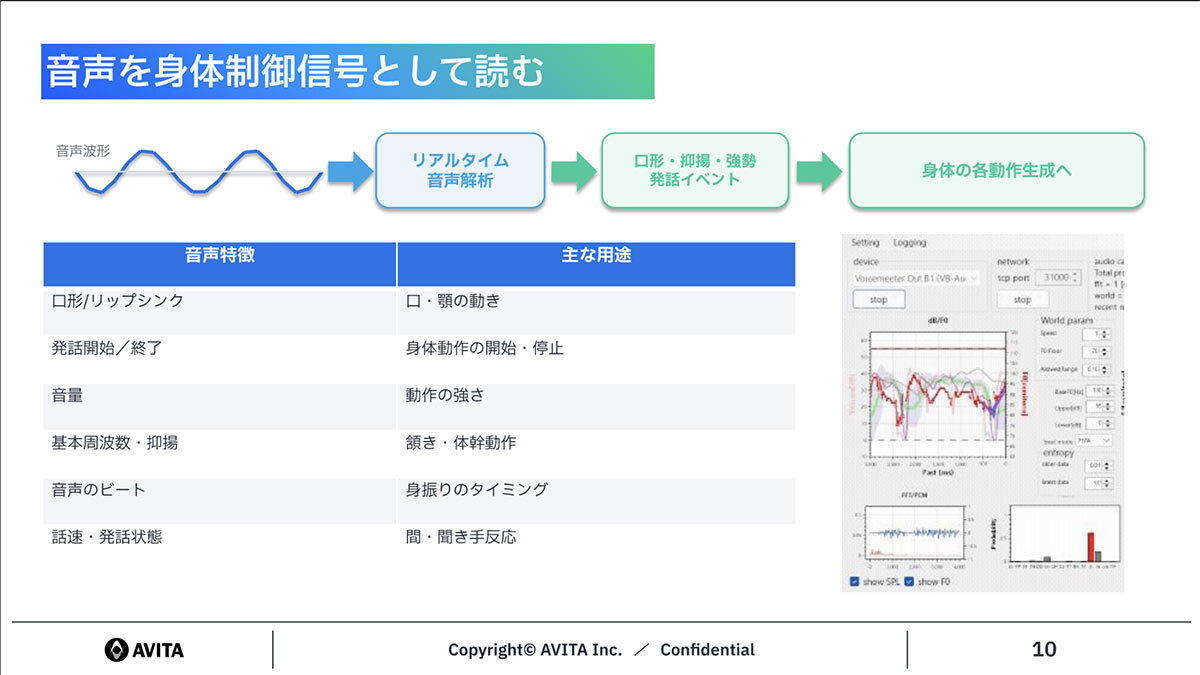
今回のセッションのテーマは、これらのプロダクトを支える「音声から身体動作をリアルタイムに生成する」エンジンだ。石黒研究室で20年以上培われてきた身体対話生成の研究を基盤に、TTS音声やオペレーターの肉声をリアルタイムに音声解析し、身体動作を生成する。
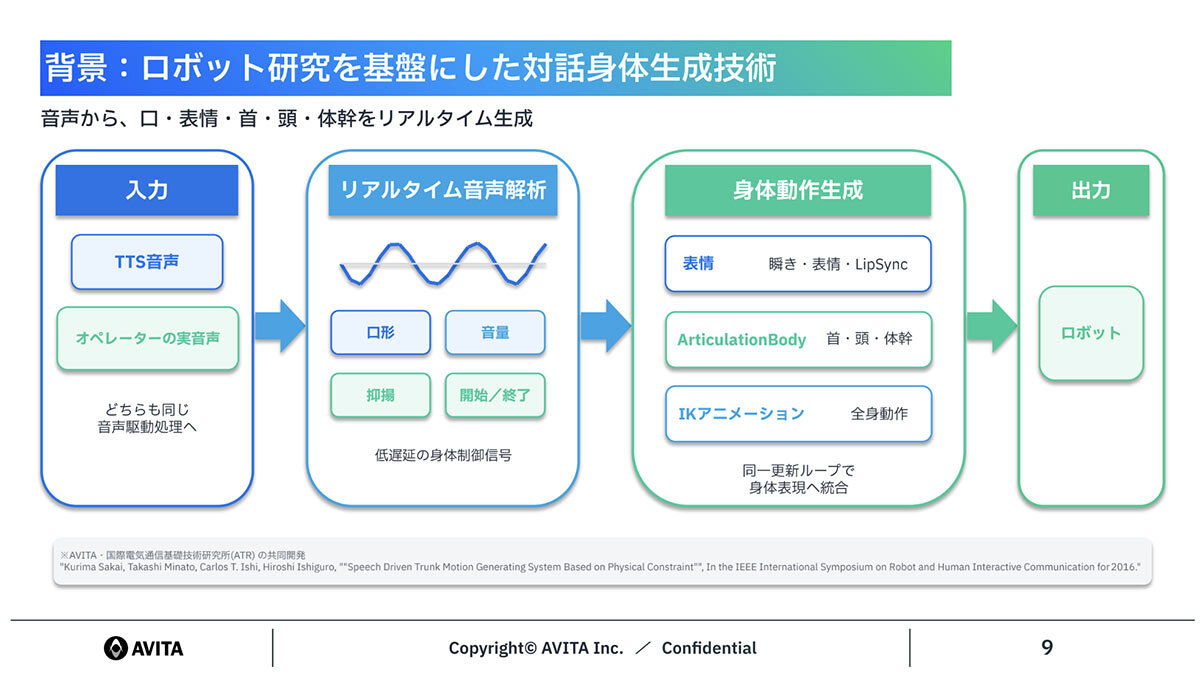
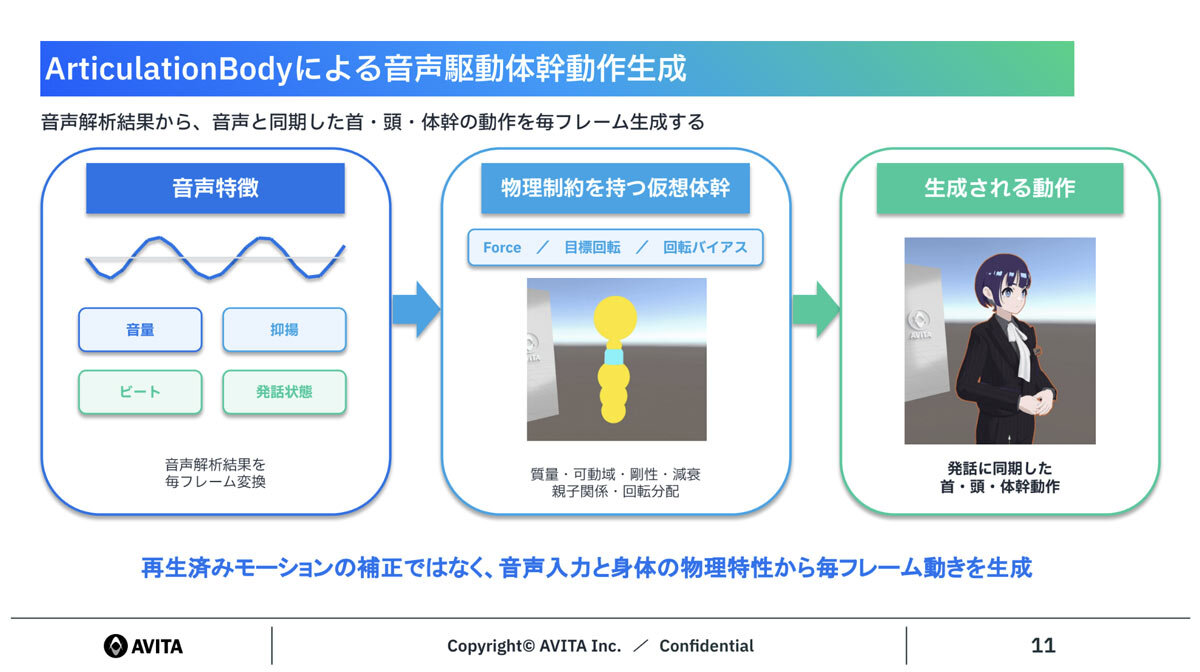
デモでは、発話区間・音量・基本周波数・抑揚のビートといった音声特徴量をルールベースで解析し(1ミリ秒程度の軽量な処理)、その結果をUnityのArticulationBody(多関節ロボットアーム向けの物理シミュレーション機能)で構築した上半身の物理モデルに、頭部への力や回転角度として加える仕組みが披露された。これにより、柔らかいバネで頭部と身体をつなぐような、自然な「喋っている風」の揺らぎが生まれる。さらに、アニメーターが用意した短いモーションクリップをMotionMatchingで自然につなぐことで、発話の開始・区切りに応じた身体全体の大きな動きも実現し、実機での喋る・止まるデモがリアルタイムで示された。
この動作生成基盤は、画面の中のCGアバターから、物理的な実体であるヒューマノイドロボットまで、存在形態を横断して応用されている。CGアバターとしての利用に加え、Unreal Engine上で作成した高品質なMetaHumanアバターに対しては、UnityをDedicated Server(デディケイテッド・サーバー / 専有・専用サーバー)として裏で稼働させ、リグ情報とARKitブレンドシェイプ値をUnrealとやり取りすることでリアルタイムに駆動する仕組みを構築。さらに、実機のヒューマノイドロボットに対しては、関節可動域の制約も含めて全身をArticulationBodyでシミュレーションし、Kinectによるトラッキングとほぼリアルタイムのレスポンスで動作を再現するデモも披露された。
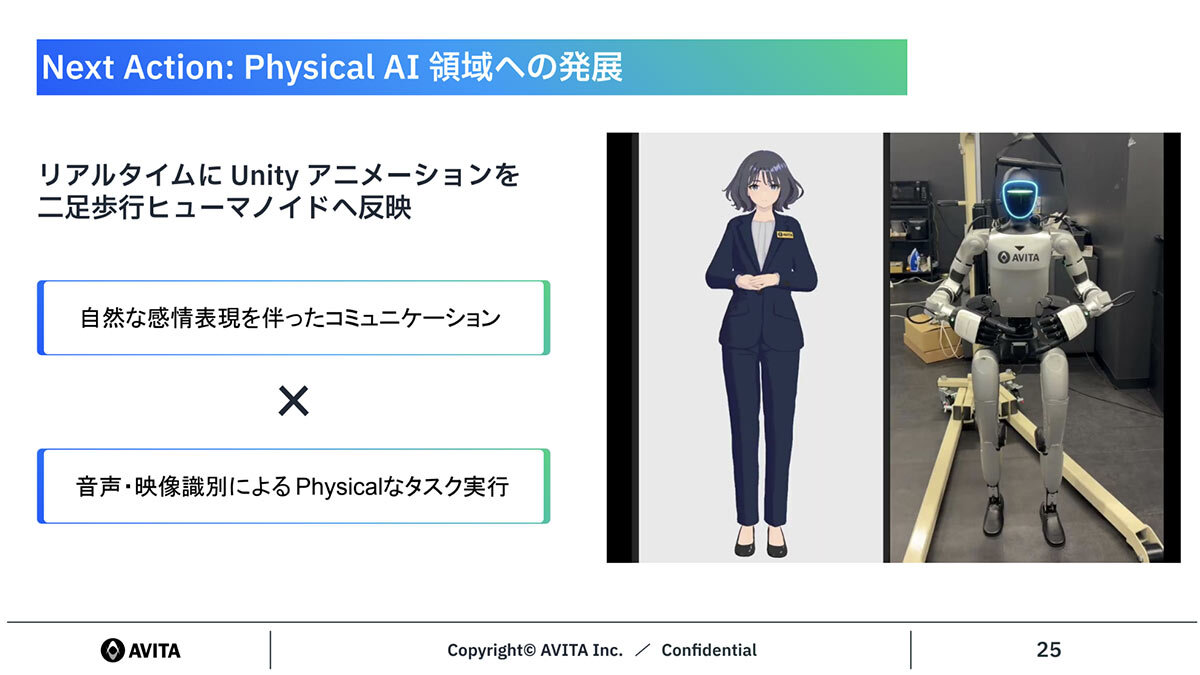
締めくくりには、Unitree・Booster Roboticsとの提携により進めている二足歩行ヒューマノイドへのUnityアニメーション適用の取り組みが紹介された。学習ベースの制御によって、CGアバターと同じ動きを実機ロボットがバランスを崩さず再現できることを確認したといい、今後は音声・映像認識に基づくフィジカルなタスク遂行(VLA:Vision-Language-Action)と、今回紹介した自然な感情表現を組み合わせることで、より人間らしいコミュニケーションと物理タスクの両立を実現するロボット開発を目指すという展望が語られた。
展示エリアでは実機デモを紹介、講演後には懇親会も
会場外の展示エリアでは、ホロラボによるtorinomeのUI移行デモ(Canvas版とUXML統合版の見た目を比較できる展示)、スロースネットワークスによる複数デバイス検証環境およびコンテンツマネジメントツールのデモ、そしてサイコムデュアル水冷GPU搭載のハイスペックPCなどが展示され、休憩時間を中心に多くの来場者で賑わった。講演終了後には懇親会も開催され、登壇者と参加者が直接情報交換や課題共有を行う場となった。
「Unity Industry」の詳細はこちらTEXT&EDIT_永田睦子/Mutsuko Nagata
PHOTO_弘田 充/Mitsuru Hirota